将任意页面 Scrape 为可直接用于 LLM 的 Markdown,JS 密集型和受反机器人保护的网站也不在话下
网页数据 API 的 /scrape 端点可对任意公开 URL 进行 Scrape,并返回干净的 Markdown,您的模型无需额外清洗即可直接读取;如需完整页面,也可返回 HTML。这就是免去基础设施烦恼的 LLM 网页抓取:JavaScript 渲染、代理轮换和反机器人检测处理均由我们负责,您的 AI 智能体拿到的是页面内容,而不是 CAPTCHA 验证页面。
试试示例
可直接接入:


100+
现成模板
99.99%
成功率
200
每秒请求数
1.25 亿+
全球 IP
最多 1 万次
免费请求
LLM 网页抓取,告别繁琐的底层搭建
抓取工具通常所需的各项基础设施,无论是渲染、轮换还是重试,我们都已为您处理好。您只需专注于构建自己的业务逻辑,而无需为获取页面编写代码。

直接 Scrape 为 Markdown
将 Markdown 参数设为 true,即可以 Markdown 格式获取页面结构。内容进入嵌入模型前,无需再进行 HTML 清洗。

像真实浏览器一样渲染 JS 密集型页面
无需自行搭建无头浏览器,即可从单页应用和动态加载的内容中提取数据。

Scrape 畅通无阻,不怕被封禁
代理轮换和指纹管理均由我们负责,受保护的目标网站不再是需要单独攻克的工程项目。

定位特定市场或地区
传入国家/地区参数,即可像当地用户一样查看页面,适用于价格核查、本地化 SEO 或有地域限制的内容。

页面一有变化,即刻响应
将 /scrape 与您自己的轮询机制或我们的 Webhook 支持相结合,即可构建实时提醒,无需再定时运行脚本。

以 AI 智能体偏好的格式获取页面
发送请求后,即可获取 HTML、Markdown 或 XHR 格式的结果;在支持的情况下,还可获取 JSON、CSV 或 PNG 格式。
为您的 AI 智能体添加网页抓取能力
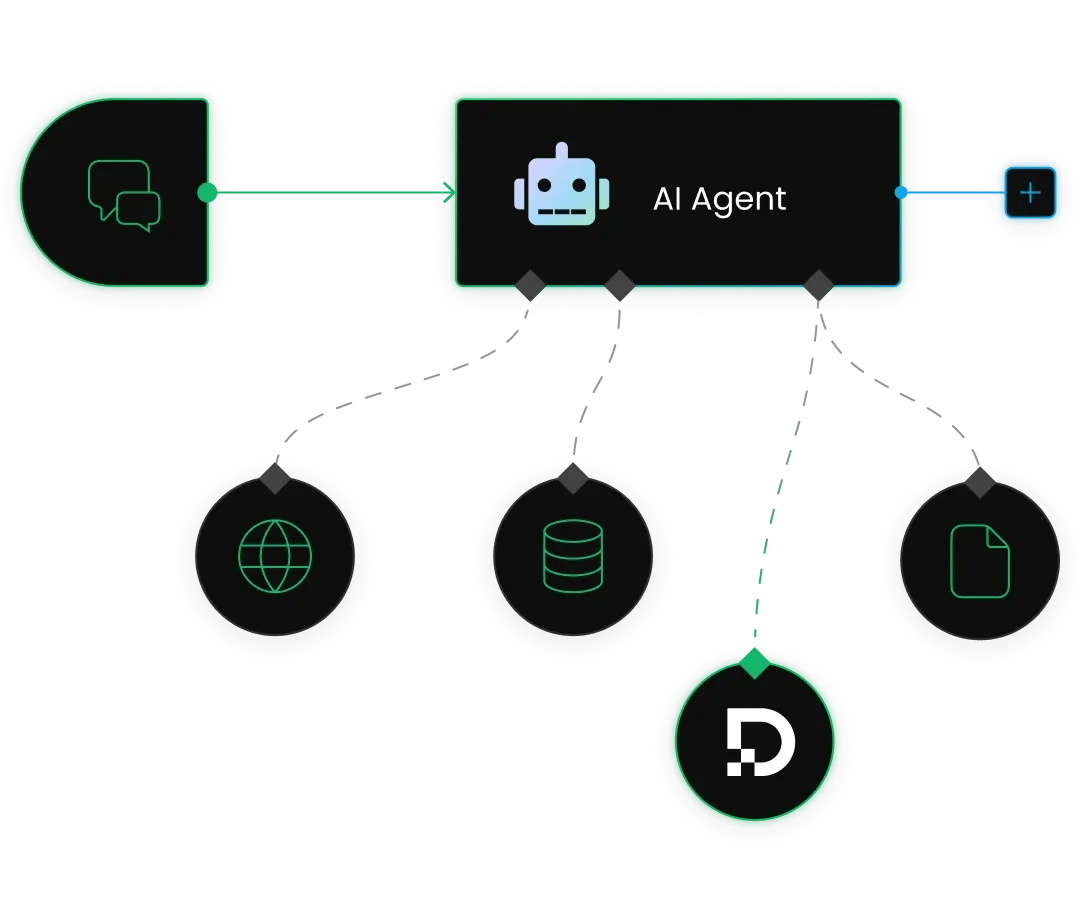
只需几行 JSON 配置,即可将 Decodo MCP 服务器连接到 Claude、Cursor 或 Windsurf。您的 AI 智能体将获得 scrape_as_markdown 工具,可将任意页面以 Markdown 格式返回,无需编写自定义工具代码。Decodo 的 MCP 服务器已收录于 GitHub 官方 MCP 注册表。
我们已覆盖所有核心集成。使用 n8n 实现自动化?只需添加 Decodo n8n 节点并传入 URL。使用 LangChain 或 OpenClaw 进行开发?LangChain 集成和 OpenClaw 技能会自动为您调用 /scrape,只需简单修改配置,无需重写整个脚本。
精选于:


灵活定价,随您的网页数据需求扩展
从免费套餐开始,每月最多 1 万次请求,之后再根据您的使用场景和用量选择最合适的订阅方案。
每种计划您都可以访问:

JavaScript 渲染
99.99% 成功率
支持 HTML、Markdown、XHR,以及 JSON、CSV、PNG(视目标而定)
一键接入 AI 集成
可直接用于 LLM 的 Markdown 格式
100+ 个预置模板
一个 API 密钥,通用所有端点
/scrape、/search、/map、/crawl
24/7 技术支持
14天退款保障
SSL安全支付
您的信息受256位SSL加密保护


常见问题
什么是 LLM 网页抓取?
LLM 网页抓取是指以大语言模型可直接使用的格式(例如干净的 Markdown 或结构化 JSON,而非 HTML)收集网页内容。Decodo 网页数据 API 正是为此打造,通过一个 API 密钥下的四大端点(/scrape、/map、/crawl 和 /search),为 AI 智能体和 RAG 流水线提供数据。
如何通过 API 将 URL Scrape 为 Markdown?
使用网页数据 API,只需将 URL 发送至 /scrape 端点,并将输出格式设为 Markdown 即可,JavaScript 渲染和反机器人绕过均会自动处理。
开始使用前,请先在 Decodo 仪表盘的网页数据 API 板块中激活免费套餐(每月最多 1 万次请求),然后参考 API 文档中的 Python 和 TypeScript 示例脚本即可。
为什么要 Scrape 为 Markdown,而不是 HTML?
HTML 中充斥着标签、脚本和样式代码,对 LLM 而言毫无意义,只会增加噪音并消耗 token。Markdown 在去除标记的同时保留了内容及其结构(标题、列表、链接),处理成本更低,也更便于为 RAG 进行分块。网页数据 API 可返回干净的、可直接用于 LLM 的 Markdown、结构化 JSON 或 HTML,您可以根据自己的数据流水线选择合适的格式。
Scrape 单个 URL 与 Crawl 整个网站有什么区别?
使用 /scrape 时,只会提取您指定的单个页面。使用 /crawl 时,系统会自动追踪网站页面,每个任务最多可将 1 万个页面提取为 Markdown 或 JSON;此外,您还可以先使用 /map 从域名的站点地图和链接中发现约 14.7 万个 URL。
AI 智能体能否使用 /scrape 抓取网页?
可以。AI 智能体可按需调用 /scrape 提取页面,依托 Decodo 1.25 亿+ IP 资源池,在受保护目标上的成功率高达 99.99%+。对于更复杂的任务,AI 智能体还可搭配 /search 获取实时网页结果,搭配 /crawl 进行全站数据提取。我们的文档中也提供了 MCP 设置指南。
/scrape 端点实际可以用来构建什么?
任何需要干净读取网页内容、又不想自己维护抓取逻辑的项目都可以,例如价格和库存监控工具、RAG 数据摄取流水线、潜在客户开发工具、调研智能体,或您自有产品背后的数据层。您只需发送一个 URL,即可获得干净的数据。
告别抓取基础设施的维护烦恼
专注于构建您的项目,页面抓取交给 /scrape。当您的 AI 基础设施需要的不只是单个页面时,/map、/crawl 和 /search 也已在同一 API 密钥下准备就绪。每月最多 1 万次免费请求,无需绑定信用卡。